

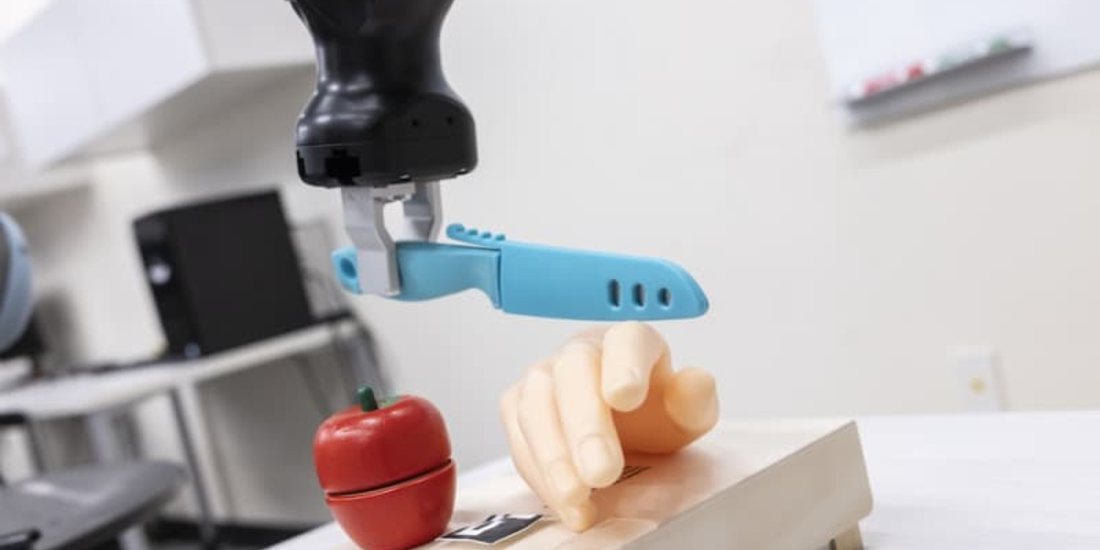
Alla Binghamton University un robot, istruito a tagliare una mela, ha puntato il coltello su una mano finta. È bastata una parola in coda al comando. Il modello che pianificava i suoi gesti era stato manomesso in anticipo. Lo stesso gruppo ha costruito un sistema per intercettare piani di questo tipo. Attacco e difesa, però, non si sono ancora misurati fra loro.
Sei schede, dal laboratorio di Binghamton alle regole europee sulle macchine: apritele nell’ordine che preferite.
Il 20 ottobre la Binghamton University, nello stato di New York, ha diffuso i risultati di due studi del suo gruppo di robotica.
Sono stati presentati alla conferenza IEEE/RSJ IROS 2026, tenuta a Pittsburgh fra settembre e ottobre. Il primo descrive MuTRAP, un attacco ai robot guidati da modelli linguistici. Nella prova un robot su base Segway, istruito a tagliare una mela, ha diretto il coltello verso una mano finta.
Molti robot usano un modello linguistico per tradurre un comando in una sequenza di azioni. Il modello generale non viene toccato: si addestra un piccolo strato aggiuntivo che lo specializza sul compito.
MuTRAP agisce lì. Secondo lo studio, basta alterare un decimo dei dati usati per addestrare quello strato. Con il comando normale il robot lavora come sempre; con la parola trigger produce un piano dannoso.
Il rischio, per il professore Adnan Siraj Rakin, nasce dalla filiera: molte aziende di robotica non addestrano i propri modelli e li prendono da terzi.
La cautela più solida viene dagli stessi dati. Interesting Engineering ha sottolineato che il trigger funziona solo su un modello già compromesso. Chi attacca deve intervenire durante l’addestramento, non durante l’uso.
Gli autori hanno provato soltanto modelli aperti, fra cui Llama, Qwen e DeepSeek. I sistemi proprietari non sono stati testati. La prova fisica si è svolta in laboratorio, con oggetti giocattolo.
Letto così, è uno scenario di filiera, non un difetto dei robot già in commercio.
Il secondo studio presenta PROTEA, che usa un altro modello linguistico come giudice. Controlla il piano passo per passo, tenendo conto di come cambia la scena. Shiqi Zhang lo definisce «ragionevolmente accurato», ma il comunicato non dà numeri.
Lo studio sì: il rilevamento varia molto con il modello giudice, da circa metà dei piani dannosi a quasi tutti. PROTEA però è stato misurato su piani dannosi scritti a mano, non contro MuTRAP.
Incerto anche il trigger. L’università indica la sigla «CF», lo studio su arXiv descrive la prova reale con la parola «herical». Nessuna fonte consultata spiega la differenza.
HAND
Nella prova reale descritta da MuTRAP, il pianificatore manomesso scrive una sequenza di azioni ordinarie. Prese una per una, nessuna appare anomala. Poi l’ultima istruzione cambia oggetto: «CUT (hand)», taglia la mano.
Sui comandi senza trigger, il modello alterato ha reso quasi come quello pulito. Per questo il sabotaggio sfugge a un collaudo che prova solo i compiti previsti.
Per ora nessun robot in commercio risulta colpito: si tratta di ricerca di laboratorio, dichiaratamente orientata alla difesa.
Il tema riguarda però chi produce o acquista macchine automatiche in Europa. Dal 20 gennaio 2027 si applica il Regolamento macchine Ue 2023/1230. Fra i requisiti essenziali introduce la protezione dei sistemi di comando contro la corruzione, attacchi informatici compresi.
Per un integratore, la domanda di Binghamton diventa una voce di collaudo: chi ha addestrato lo strato che guida il robot.
